
গ্রিয়ারসনের ভাষা-জরিপে পার্বত্য চট্টগ্রাম: 1903 সালের নথিতে কী আছে
Last updated Nov 3rd, 2026
0
জর্জ আব্রাহাম গ্রিয়ারসনের Linguistic Survey of India-তে পার্বত্য চট্টগ্রামের ভাষাগুলো একটি বইয়ে নেই, ছড়িয়ে আছে চারটি খণ্ডে। চাকমা আছে বাংলা ভাষার খণ্ডে (খণ্ড 5, ভাগ 1, 1903, পৃ. 321–350), ত্রিপুরা বোড়ো দলের খণ্ডে (খণ্ড 3, ভাগ 2, 1903, পৃ. 109), আর ম্রো, বনযোগী, পাংখু, খুমি ও খিয়াং কুকি-চিন ও বার্মা দলের খণ্ডে (খণ্ড 3, ভাগ 3, 1904)। মারমা ভাষা জরিপ থেকে বাদ পড়েছিল; তার জন্য আছে শুধু একটি পাদটীকা।
এই লেখা একটি পাঠক-নির্দেশিকা: গ্রিয়ারসন ভাষা জরিপ চাকমা, ত্রিপুরা, ম্রো বা খুমি ভাষা নিয়ে ঠিক কোন পাতায় কী লিখেছে, সংখ্যাগুলো কত, নমুনা কারা পাঠিয়েছিলেন, আর স্ক্যান করা পাতাগুলো archive.org ও শিকাগো বিশ্ববিদ্যালয়ের Digital South Asia Library (DSAL)-এ কোথায় পাওয়া যায়। উদ্ধৃতিগুলো মূল পাতা থেকে নেওয়া, বাংলা অনুবাদসহ। “tribe”, “corrupt”, “wild” — এ ধরনের শব্দ গ্রিয়ারসন ও তাঁর সহযোগীদের, ঔপনিবেশিক সময়ের পরিভাষা; উদ্ধৃতির ভেতরেই সেগুলো রাখা হয়েছে।
চাকমা বর্ণমালার যে ছকটি এই জরিপে প্রথম ছাপা হয়, তার বিস্তারিত আছে আমাদের চাকমা লিপি (অঝাপাত)-বিষয়ক লেখায়; সতীশচন্দ্র ঘোষের বই নিয়ে আছে ‘চাকমা জাতি’ (1909)-বিষয়ক লেখা; বম, খুমি, খিয়াং, লুসাই ও পাংখোয়া ভাষার আজকের শ্রেণিবিন্যাস আছে কুকি-চিন ভাষা নিয়ে লেখায়। এখানে সেগুলো আবার বলা হয়নি।
এক নজরে: পার্বত্য চট্টগ্রামের কোন ভাষা জরিপের কোন খণ্ডের কোন পাতায়
পার্বত্য চট্টগ্রামের সাতটি ভাষার আলাদা অংশ আছে জরিপে: চাকমা, ত্রিপুরা, ম্রো, বনযোগী, পাংখু, খুমি ও খিয়াং। মারমা আছে কেবল পাদটীকায়। লুসাইয়ের অংশ আছে, কিন্তু পার্বত্য চট্টগ্রামের কোনো সংখ্যা নেই। নিচের ছকে নাম, খণ্ড, পাতা ও জরিপে লেখা পার্বত্য চট্টগ্রামের বক্তাসংখ্যা — সবই মূল পাতা থেকে।
| আজকের নাম | জরিপে নাম ও শ্রেণি | খণ্ড, ভাগ, সাল | শুরুর পাতা | পার্বত্য চট্টগ্রামে বক্তা (জরিপের হিসাব) |
|---|---|---|---|---|
| চাকমা | “Chākmā Sub-dialect” — দক্ষিণ-পূর্ব বাংলা উপভাষার অংশ, ইন্দো-আর্য পরিবার | 5, ভাগ 1, 1903 | 321 (দক্ষিণ-পূর্ব বাংলা অংশ শুরু 291) | 20,006 (পৃ. 291-এর ছক); “about 20,000” (পৃ. 321) |
| ত্রিপুরা (ককবরক) | “Tipurā” — বোড়ো দল, তিব্বতি-বর্মি পরিবার; পার্বত্য চট্টগ্রামে “Mrung” | 3, ভাগ 2, 1903 | 109 | 15,250 |
| মারমা | “Maghī” — জরিপের বাইরে রাখা | 3, ভাগ 3, 1904 | 379 (পাদটীকা) | 22,500 |
| ম্রো | “Mrū” — বার্মা দলে, অস্থায়ীভাবে | 3, ভাগ 3, 1904 | 385 | 2,100 (বোমাং 2,000 + চাকমা সার্কেল 100) |
| বম | “Banjōgī” — কুকি-চিন, মধ্য চিন | 3, ভাগ 3, 1904 | 144 | 800 (পৃ. 144); সারণিতে 500 (পৃ. 3) |
| পাংখোয়া | “Pānkhū” — কুকি-চিন, মধ্য চিন | 3, ভাগ 3, 1904 | 152 | 500 (পৃ. 152); সারণিতে 800 (পৃ. 3) |
| খিয়াং | “Sho or Khyang” — কুকি-চিন, দক্ষিণ চিন | 3, ভাগ 3, 1904 | 331 | “about 100” (বোমাং সার্কেল) |
| খুমি | “Khami” — কুকি-চিন, দক্ষিণ চিন | 3, ভাগ 3, 1904 | 347 | “About 500” |
| লুসাই | “Lushei or Dulien” — কুকি-চিন, মধ্য চিন | 3, ভাগ 3, 1904 | অংশের শিরোনাম “Lushei or Dulien” | পার্বত্য চট্টগ্রামের আলাদা সংখ্যা নেই |
দুটি কথা মনে রাখা দরকার। প্রথমত, এগুলো বক্তার সংখ্যা, জনগোষ্ঠীর নয়, আর অনেকগুলো জরিপের নিজের ভাষায় স্থানীয় কর্মকর্তাদের “estimate”। দ্বিতীয়ত, বই দুটিতে ছাপা পাতার নম্বর আর স্ক্যানের ক্রমিক নম্বর আলাদা; শেষের “স্ক্যান কোথায় পড়বেন” অংশে কোন লিংকে কোন পাতা খুলবে তা দেওয়া আছে।
Linguistic Survey of India কী, আর কারা এটি বানিয়েছিলেন
Linguistic Survey of India ব্রিটিশ ভারতের ভাষা ও উপভাষার একটি সরকারি জরিপ, যার সংকলক ও সম্পাদক জর্জ আব্রাহাম গ্রিয়ারসন (1851–1941)। স্থানীয় কর্মকর্তাদের পাঠানো নমুনা থেকে প্রতিটি ভাষার পরিচিতি, ব্যাকরণের সংক্ষিপ্ত বিবরণ ও নমুনা-পাঠ ছাপা হয়। খণ্ডগুলো বেরিয়েছিল কলকাতা থেকে, 1903 থেকে 1928 সালের মধ্যে।
বাংলাপিডিয়া লেখে, 1886 সালে ভিয়েনার আন্তর্জাতিক প্রাচ্যবিদ্যা সম্মেলনে গ্রিয়ারসন ভারতীয় ভাষাগুলো নিয়ে ব্যাপক গবেষণার প্রয়োজনের কথা বলেন, আর 1898 সালে সরকার তাঁকে এই কাজের সুপারিন্টেন্ডেন্ট নিয়োগ করে। ইংরেজি উইকিপিডিয়া লেখে, প্রস্তাবটি প্রথমে নাকচ হয়েছিল, 1891 সালে অনুমোদন পায়, আর কাজ আনুষ্ঠানিকভাবে শুরু হয় 1894 সালে।
খণ্ড আর ভাষার সংখ্যা নিয়েও উৎসগুলো এক কথা বলে না। বাংলাপিডিয়া লেখে, 1903–27 সালের মধ্যে 20 খণ্ডে 8,000 পৃষ্ঠায় জরিপটি প্রকাশিত হয় এবং এতে 364টি ভাষা ও উপভাষা আছে; উইকিপিডিয়াও 364 লেখে, তবে শেষ খণ্ডের সাল দেয় 1928। DSAL-এর ক্যাটালগ লেখে “11 v. in 20”, প্রকাশকাল 1903–1928, আর তাদের পরিচিতি-পাতা লেখে 179টি ভাষা ও 544টি উপভাষা।
নমুনা সংগ্রহের পদ্ধতি
খণ্ড 1, ভাগ 1-এ (1927) গ্রিয়ারসন নিজে পদ্ধতিটি লিখেছেন। প্রতিটি জেলার কর্মকর্তাকে স্থানীয় প্রতিটি ভাষার তিনটি নমুনা পাঠাতে বলা হয়েছিল: বাইবেলের “অপব্যয়ী পুত্রের দৃষ্টান্ত” (Parable of the Prodigal Son)-এর অনুবাদ, স্থানীয়ভাবে বাছাই করা একটি পাঠ, আর ছাপানো ফর্মে একটি “standard list of words and sentences” — শব্দ ও বাক্যের মানক তালিকা। নমুনা লিখতে হতো স্থানীয় হরফে (যদি থাকে) আর রোমান হরফে, শব্দে শব্দে ইংরেজি অনুবাদসহ।
গ্রিয়ারসনের হিসাবে নমুনা আসতে শুরু করে 1897 সালে, বেশিরভাগ পৌঁছে যায় 1900-এর শেষ নাগাদ; সম্পাদনা শুরু হয় 1898 সালে। যাঁরা অনুবাদ করবেন তাঁরা অনেকে ইংরেজি জানবেন না, তাই 1897 সালে ভারতীয় ভাষায় দৃষ্টান্তটির 65টি অনুবাদ নিয়ে একটি সংকলন ছাপা হয়, যাতে প্রত্যেকে অন্তত একটি পরিচিত ভাষা থেকে অনুবাদ করতে পারেন।
খণ্ড 1-এ (পৃ. 19) গ্রিয়ারসন আরও লেখেন, স্থানীয় তালিকার ভাষাগুলোকে দুই ভাগ করা হয়েছিল — যেগুলো ওই এলাকার নিজস্ব “vernacular”, আর যেগুলো “spoken by foreigners” — এবং দ্বিতীয় ভাগটি “once for all excluded”, অর্থাৎ একবারেই বাদ।
অ-ইন্দো-ইউরোপীয় খণ্ডগুলো কার লেখা
DSAL-এর পরিচিতি-পাতা অনুযায়ী অ-ইন্দো-ইউরোপীয় ভাষার পাঁচটি খণ্ড তৈরি করেছিলেন নরওয়ের ভাষাবিদ Sten Konow। পার্বত্য চট্টগ্রামের তিব্বতি-বর্মি ভাষাগুলো — ত্রিপুরা, ম্রো, বনযোগী, পাংখু, খুমি, খিয়াং — এই ভাগে পড়ে। খণ্ড 1-এ গ্রিয়ারসন লিখেছেন, 1900 থেকে 1902 পর্যন্ত তাঁরা দুজন “side by side, in the same room” কাজ করেছেন, আর জরিপের “a large part … has come directly from his pen” — বড় একটি অংশ সরাসরি Konow-এর কলম থেকে। আমাদের পাংখোয়া জনগোষ্ঠী নিয়ে লেখায় ভাষাবিদ জাহিদ আকতারের উদ্ধৃতিতে পাংখু অংশটি “Konow, 1903” নামে উল্লেখ আছে। খণ্ডগুলোর নামপত্রে অবশ্য সংকলক ও সম্পাদক হিসেবে গ্রিয়ারসনের নামই ছাপা।
পার্বত্য চট্টগ্রাম থেকে নমুনা কারা পাঠিয়েছিলেন, কীভাবে পৌঁছেছিল
পার্বত্য চট্টগ্রামের নমুনাগুলো এসেছিল জেলা প্রশাসনের মাধ্যমে, আর কয়েকটি ক্ষেত্রে জরিপ নিজেই নমুনাগুলোকে অবিশ্বস্ত বলেছে। একটিমাত্র ক্ষেত্রে স্থানীয় তথ্যদাতার নাম ছাপা আছে: চাকমা বর্ণমালার তথ্য দিয়েছিলেন দেওয়ান কৃষ্টচন্দ্র, পাঠিয়েছিলেন পার্বত্য চট্টগ্রামের সহকারী কমিশনার J. A. Cave-Browne।
গ্রিয়ারসনের ভাষায় তথ্যদাতা ছিলেন “a gentleman of Chākmā nationality” — চাকমা জাতির একজন ভদ্রলোক (খণ্ড 5, ভাগ 1, পৃ. 321)। আমাদের আর্কাইভে তনয় দেওয়ানের ‘চাংমাটারা – চাকমা জাতির সংক্ষিপ্ত ইতিহাস’ এই ঘটনাকে লিখেছে: “কৃষ্টচন্দ্র দেওয়ান কর্তৃক মি. গ্রীয়ারসনকে প্রেরিত প্রথম চাকমা বর্ণমালা ১৯০৩ সালে লিংগুস্টিক সার্ভে অব ইন্ডিয়া গ্রন্থে প্রকাশিত হয়।”
অন্য ভাষাগুলোর নমুনা নিয়ে জরিপের মন্তব্য প্রায় একই রকম। বনযোগীর দৃষ্টান্ত-অনুবাদ ও শব্দতালিকা সম্পর্কে লেখা হয়েছে “Both are very corrupt” — দুটিই খুব ভুলে ভরা (পৃ. 145); পাংখুর গুলো “full of mistakes” (পৃ. 152); খুমির গুলো “very corrupt” (পৃ. 348); আর ম্রোর গুলো “extremely corrupt and untrustworthy” — অত্যন্ত ভুলে ভরা ও অবিশ্বস্ত, যদিও ম্রো ব্যাকরণের টীকার “only foundation” ওই নমুনাই (পৃ. 386)। খিয়াং নিয়ে লেখা হয়েছে, পার্বত্য চট্টগ্রাম থেকে আসা পাঠ দেখে উপভাষাটির “fair idea” পাওয়া প্রায় অসম্ভব, তাই বার্মার দুই লেখকের ব্যাকরণ থেকে বিবরণ নেওয়া হয়েছে (পৃ. 331)।
এক সাক্ষীর জবানবন্দি, চার ভাষা পেরিয়ে
জরিপের দুটি জায়গায় পার্বত্য চট্টগ্রামের একটি মামলার কথা আছে। চাকমা অংশের শুরুতে (খণ্ড 5, ভাগ 1, পৃ. 321) লেখা: একজন খুমি নারী নিজের ভাষা ছাড়া আর কোনো ভাষা জানতেন না; তাঁর সাক্ষ্য ম্রো ভাষায় অনুবাদ হয়, ম্রো থেকে “Maghī”-তে, সেখান থেকে দক্ষিণ-পূর্ব বাংলায়, আর সেই বাংলা থেকে ম্যাজিস্ট্রেট সাক্ষ্যটি ইংরেজিতে লেখেন।
খণ্ড 1, ভাগ 1-এ (পৃ. 21) গ্রিয়ারসন একই ঘটনা আবার বলেছেন — এবার শিকলটি খুমি থেকে ম্রো, ম্রো থেকে “Arakanese”, তারপর স্থানীয় বাংলা, শেষে ইংরেজি — আর ম্যাজিস্ট্রেটের লেখা সাক্ষ্যকে বলেছেন “quadruply refracted evidence”, চারবার প্রতিসরিত সাক্ষ্য। একই পাতায় তিনি লেখেন, এমন বহু ভাষার জন্য এমন কাউকে পাওয়া যায়নি, যিনি ভাষাটি আর ইংরেজি দুটোই জানেন। পার্বত্য চট্টগ্রামের নমুনাগুলো কোন পথ পেরিয়ে কলকাতায় পৌঁছেছিল, এই উদাহরণ তার একটি ছবি দেয়।
চাকমা অংশের একই অনুচ্ছেদে আরেকটি পর্যবেক্ষণ: পার্বত্য চট্টগ্রামের বেশিরভাগ অংশে দক্ষিণ-পূর্ব বাংলা “a kind of Lingua Franca” — এক রকম সংযোগ-ভাষা — হিসেবে চলে, অনেকগুলো তিব্বতি-বর্মি ভাষার পাশাপাশি; পূর্ব দিকের জনগোষ্ঠীগুলোর মধ্যে এই সংযোগ-ভাষাও নেই।
গ্রিয়ারসন ভাষা জরিপ: চাকমা ভাষাকে কোথায় রেখেছিল
জরিপে চাকমা আলাদা ভাষা নয়, বাংলার একটি “sub-dialect” — উপ-উপভাষা — হিসেবে আছে: বাংলা ভাষার খণ্ডে (খণ্ড 5, ভাগ 1, 1903), দক্ষিণ-পূর্ব বাংলা উপভাষার ভেতরে, শিরোনাম “Chākmā Sub-dialect”, পৃ. 321 থেকে। একই পাতায় অবশ্য লেখা, ভাষাটি এত বদলেছে যে একে আলাদা ভাষার মর্যাদা দেওয়া “almost” যায়।
পুরো বাক্যটি এ রকম: কর্ণফুলী নদীর আশপাশে চাকমা চিফের সার্কেলে “a broken dialect of Bengali” বলা হয়, যা দক্ষিণ-পূর্ব বাংলার ওপর দাঁড়িয়ে, কিন্তু “has undergone so much transformation that it is almost worthy of the dignity of being classed as a separate language” — এত রূপান্তর হয়েছে যে প্রায় আলাদা ভাষা হিসেবে গণ্য হওয়ার মর্যাদা পায়। “Broken dialect” শব্দবন্ধটি গ্রিয়ারসনের।
দক্ষিণ-পূর্ব বাংলার ভেতরে চাকমা
দক্ষিণ-পূর্ব বাংলা উপভাষার অংশ শুরু হয় পৃ. 291-এ। সেখানে গ্রিয়ারসন নোয়াখালী, চট্টগ্রাম ও আকিয়াবের কথ্যভাষাকে একসঙ্গে “South-Eastern” নাম দিয়েছেন, আর লিখেছেন চট্টগ্রামে একে “Chatgaiya” বলা হয়। বক্তার ছকে চারটি সারি: নোয়াখালী 909,199; চট্টগ্রাম 1,267,433; আকিয়াব 114,152; আর “Chittagong Hill Tracts (Chakma)” 20,006 — মোট 2,310,784। একই পাতায় এক বাক্যে বলা আছে, “A sub-dialect is spoken by the Chakmas of the Chittagong Hill Tracts, which will be described later on.”
খণ্ডের ভূমিকাতেও চাকমার উল্লেখ আছে: পূর্ব উপকূলে দক্ষিণ-পূর্ব বাংলা, আর ভেতরের দিকে “one more curious dialect, called Chakma (with an alphabet of its own)” — নিজস্ব বর্ণমালাসহ আরেকটি “অদ্ভুত” উপভাষা। 1927 সালের খণ্ড 1, ভাগ 1-এর বাংলা অংশেও (পৃ. 153–154) প্রায় একই বাক্য, সঙ্গে যোগ: চাকমার লিখিত হরফ বর্মি হরফের মতো, তবে তার চেয়ে “more archaic”।
পৃ. 321–324: বর্ণমালা আর ব্যাকরণের দুই অনুচ্ছেদ
পৃ. 321 থেকে 323 জুড়ে চাকমা বর্ণমালার ছক, স্বরচিহ্ন আর বর্মি হরফের সঙ্গে তুলনা। এর বিস্তারিত পাঠ আছে আমাদের চাকমা লিপির লেখায়। লিপির উৎস নিয়ে গ্রিয়ারসনের মত — চাকমা হরফ খমের হরফের “almost identical” — ওই লেখায় অন্য উৎসের মতের পাশে রাখা আছে।
ব্যাকরণ নিয়ে জরিপ বেশি কিছু লেখেনি। পৃ. 323-এ বলা: “It is not necessary to give a detailed account of Chakma Grammar, which closely resembles that of Chittagong” — চাকমা ব্যাকরণ চট্টগ্রামের ব্যাকরণের খুব কাছাকাছি, তাই বিস্তারিত বিবরণের দরকার নেই। এরপর কয়েকটি পর্যবেক্ষণ: মূর্ধন্য বর্ণ নিয়মিতভাবে দন্ত্য হয়ে যায় — উদাহরণ ṭhēṅ-এর জায়গায় thēṅ (পা), ghaṭaki-র জায়গায় ghadaki (ঘটক)।
পৃ. 324-এ “হওয়া” ক্রিয়ার রূপ: বর্তমান কালে āgi (আমি আছি, আমরা আছি), āgas বা nē (তুমি আছ), āgē বা nē (সে আছে); অতীতে ēlūṅ (আমি ছিলাম), ēlaṅ (আমরা ছিলাম), ēl (সে ছিল)। জরিপ লেখে, চট্টগ্রামের সঙ্গে প্রধান পার্থক্য হলো উত্তম পুরুষের ক্রিয়া শেষ হয় ūṅ বা aṅ-এ, আর অসমাপিকা ক্রিয়া শেষ হয় inai-তে, যেমন jēinai (গিয়ে)। একই পাতায় একটি পুরনো সূত্রের ঠিকানা: Journal of the Asiatic Society of Bengal-এর 1841 সালের খণ্ড 10, ভাগ 1-এ, পৃ. 712-তে, Arthur Phayre “Doing-núk” নামে একটি সংক্ষিপ্ত চাকমা শব্দতালিকা ছেপেছিলেন।
পৃ. 326–350: দুটি নমুনা — দৃষ্টান্ত আর একটি লোককথা
চাকমার দুটি নমুনা ছাপা হয়েছে, দুটিই চাকমা হরফে, তারপর রোমান হরফে শব্দে শব্দে ইংরেজি অর্থসহ। প্রথমটি (নং 74, পৃ. 326 থেকে) অপব্যয়ী পুত্রের দৃষ্টান্ত। দ্বিতীয়টির (নং 75, পৃ. 338 থেকে) শিরোনাম “A Folk-tale”; রোমান পাঠটি শুরু “Adye ek raja el” দিয়ে, আর পৃ. 350-এ আছে এর “Free translation” — ইংরেজি ভাবানুবাদ।
ভাবানুবাদ অনুযায়ী গল্পটি এক রাজার একমাত্র মেয়ের। মেয়েটি পণ করেন, যে তরুণ তাঁর দেখানো খাড়া পাহাড়ের চূড়া থেকে নদীতে লাফ দেবে, কেবল তাকেই বিয়ে করবেন। একের পর এক তরুণ লাফ দিয়ে মারা যায়। শেষে রাজা স্বপ্নে এক বৃদ্ধার কাছে উপায় পান — তরুণের গায়ে বালিশ আর ছাতা বেঁধে দিলে সে মরবে না; সেভাবে লাফ দিয়ে এক তরুণ বেঁচে যায়, আর রাজকন্যার সঙ্গে তার বিয়ে হয়।
গল্পের নিচে একটি টীকা আছে, পার্বত্য চট্টগ্রামের ভূগোলের জন্য যা কাজের: খাড়া চূড়াটি এখনো আছে, নাম “Jāmāimārōni” — ইংরেজিতে “bridegroom-killing”, অর্থাৎ বর-মারা — আর তা কর্ণফুলী নদীর তীরে, “Chitmorom”-এর কাছে, সীতাপাহাড় সংরক্ষিত বনে। টীকাটি গল্পটিকে বলেছে “a piece of folk-lore founded on tradition of great interest”। চাকমা ভাষায় জায়গাটির নাম কীভাবে লেখা হয়, আর কাহিনিটির অন্য কোনো লিখিত রূপ আছে কি না, তা কোনো উৎসে পাওয়া যায়নি।
পৃ. 351 থেকে শুরু বাংলার উপভাষাগুলোর “Standard List of Bengali Words and Sentences” — শব্দ ও বাক্যের তুলনামূলক তালিকা। জরিপ জানায়, তালিকাগুলো দৃষ্টান্ত-অনুবাদ থেকে আলাদাভাবে তৈরি, তাই দুটিতে বানানের হেরফের আছে, আর উচ্চারণ বোঝার কাজে লাগবে বলে সেগুলো ইচ্ছা করেই রেখে দেওয়া হয়েছে।
চাকমা লেখকেরা গ্রিয়ারসনের শ্রেণিবিন্যাস কীভাবে পড়েছেন
জুমজার্নালের আর্কাইভে চাকমাকে বাংলার উপভাষা ধরার সিদ্ধান্তটির সরাসরি সমালোচনা আছে। 2017 সালে মেয়েরেগা নামে লেখা একটি প্রবন্ধ বলেছে, গ্রিয়ারসন স্বতন্ত্র চাকমা ভাষাকে বাংলার উপভাষা বানিয়েছিলেন, আর একই সঙ্গে স্বীকার করেছিলেন ভাষাটি স্বতন্ত্র হওয়ার দাবি রাখে।
প্রবন্ধটির নাম ‘বিশ্বের বিভিন্ন ভাষা আন্দোলন ও চাকমা ভাষার দশা’। লেখকের যুক্তি: বাংলার সঙ্গে অনেক শব্দের মিল দেখিয়ে চাকমাকে উপভাষা করা হলে অসমিয়া বা ওড়িয়ার ক্ষেত্রেও একই যুক্তি খাটত, আর সেগুলো আলাদা ভাষা হিসেবেই স্বীকৃত বলে লেখক মনে করিয়ে দিয়েছেন। লেখাটির তথ্যসূত্রে “G.A. Grierson- Linguistic Survey of India, vol-V part-I” নাম ধরে উল্লেখ আছে।
একই প্রবন্ধ সাংবাদিক রাজীব নূরের একটি লেখার সূত্রে ঢাকা বিশ্ববিদ্যালয়ের ভাষাবিজ্ঞান বিভাগের অধ্যাপক সৌরভ সিকদারের মন্তব্য উদ্ধৃত করেছে। প্রবন্ধের ভাষায়, সৌরভ সিকদার গ্রিয়ারসনের এই বক্তব্য মানতে রাজি নন, আর বলেছেন: “আমি গবেষণা করে দেখেছি, চাকমা ভাষা বাংলা থেকে একেবারে স্বতন্ত্র একটি ভাষা।”
আজকের একটি আন্তর্জাতিক ভাষা-ক্যাটালগ, লাইপজিগের Max Planck Institute for Evolutionary Anthropology-র উদ্যোগে তৈরি Glottolog, চাকমাকে রেখেছে ইন্দো-আর্য শাখার “Gauda-Banga” ভাগে, “Southeastern Bengali” নামের দলে — তঞ্চঙ্গ্যাও আছে একই দলে। Glottolog-এ “Southeastern Bengali” একটি দলের নাম; চাকমা সেই দলের ভেতরে “language” স্তরে তালিকাভুক্ত, নিজস্ব কোড chak1266। এক শতাব্দী পরের এই শ্রেণিবিন্যাস আর গ্রিয়ারসনের “sub-dialect” পাশাপাশি রাখা হলো নিচের তুলনা-ছকে।
চাকমা অভিধানের ইতিহাস নিয়ে আমাদের আদিবাসী ভাষার অভিধান-বিষয়ক লেখায় সুগত চাকমার বই থেকে আরেকটি সূত্র আছে: তিনি গ্রিয়ারসনের 1903 সালের খণ্ডকে চাকমা ভাষা নিয়ে লেখালেখির ধারায় একটি ধাপ হিসেবে উল্লেখ করেছেন। সেখানে বিস্তারিত বলা আছে।
ত্রিপুরা ভাষা: বোড়ো দলে “Tipurā”, পার্বত্য চট্টগ্রামে “Mrung”
ত্রিপুরা ভাষা আছে খণ্ড 3, ভাগ 2-এ (1903), বোড়ো দলের ভাষা হিসেবে, শিরোনাম “Tipurā”, পৃ. 109 থেকে। জরিপের ছকে পার্বত্য চট্টগ্রামে বক্তা 15,250, আর একই পাতায় লেখা: “In the Chittagong Hill Tracts the language is also called Mrung.” — পার্বত্য চট্টগ্রামে ভাষাটিকে “ম্রুং”-ও বলা হয়।
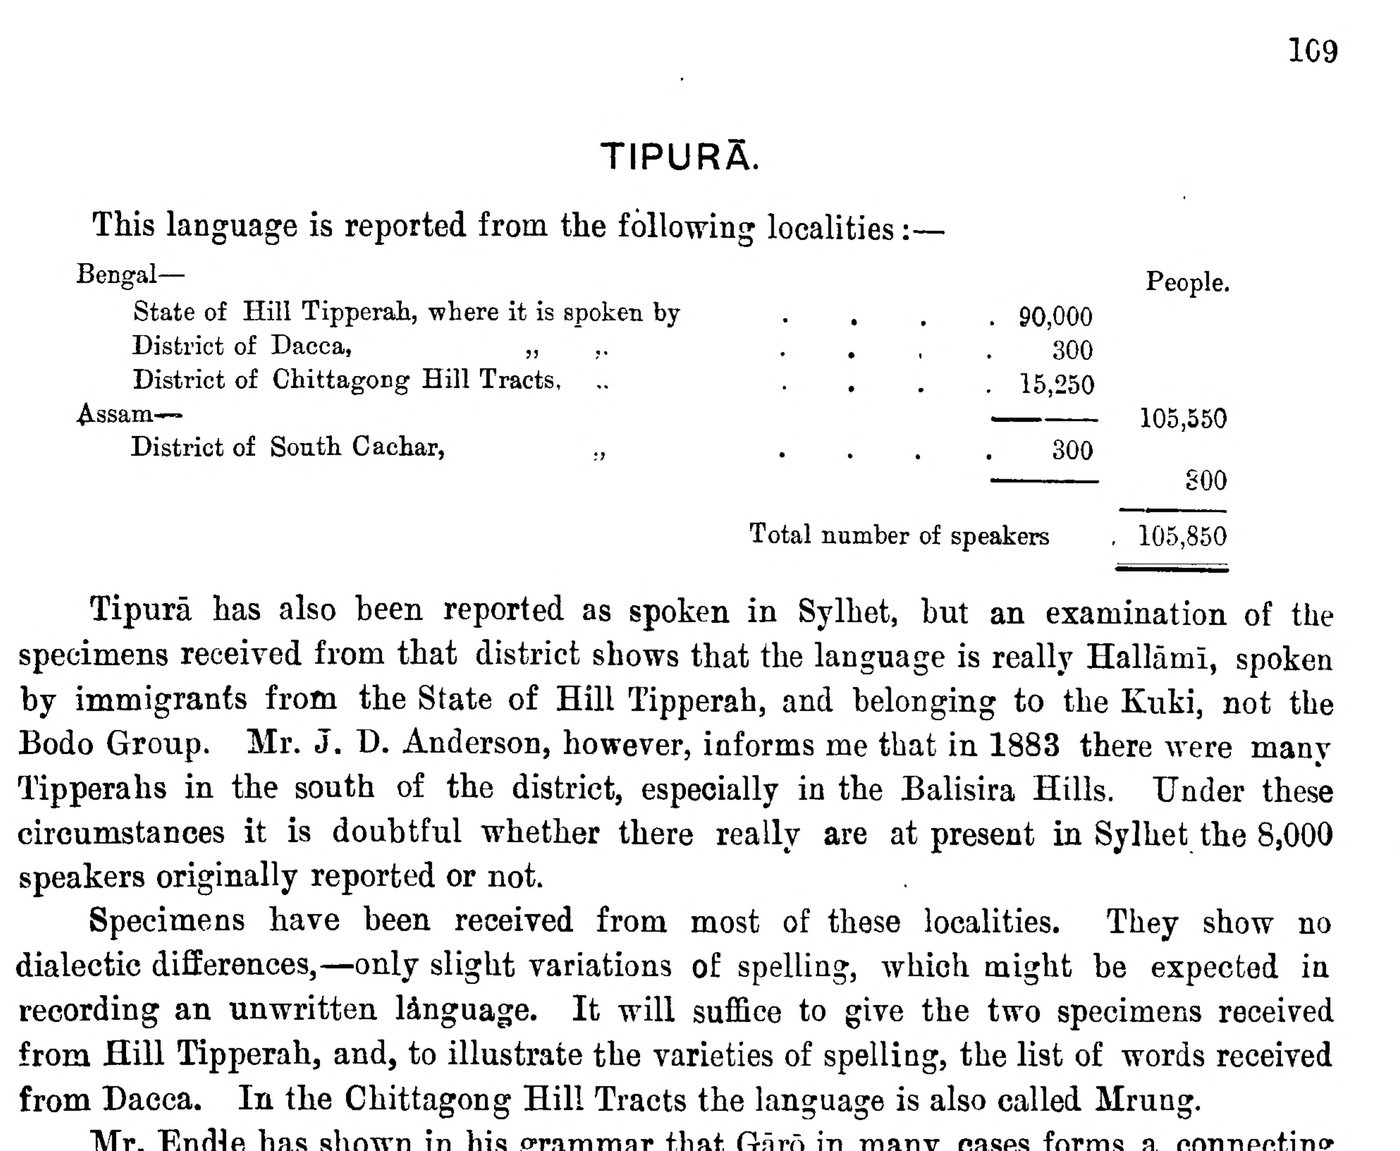
পুরো ছকটি এ রকম: হিল টিপেরা রাজ্যে 90,000, ঢাকা জেলায় 300, পার্বত্য চট্টগ্রামে 15,250 — বাংলায় মোট 105,550; আসামের দক্ষিণ কাছাড়ে 300; সব মিলিয়ে 105,850। সিলেট থেকেও ত্রিপুরা ভাষার খবর এসেছিল, কিন্তু নমুনা পরীক্ষা করে জরিপ লিখেছে সেটি কুকি দলের হাল্লাম ভাষা।
নমুনা সম্পর্কে জরিপের মন্তব্য: বিভিন্ন জায়গা থেকে আসা নমুনায় “no dialectic differences”, কেবল বানানের সামান্য হেরফের — যা একটি “unwritten language” লিখতে গেলে স্বাভাবিক। তাই ছাপা হয়েছে হিল টিপেরা থেকে আসা দুটি নমুনা আর ঢাকার শব্দতালিকা; পার্বত্য চট্টগ্রাম থেকে আসা নমুনা আলাদা করে ছাপা হয়নি। জরিপ এটিও লেখে, ত্রিপুরার নমুনা ও শব্দতালিকা মূলে বাংলা হরফে লেখা ছিল।
পৃ. 109-এর সূত্র-তালিকায় একটি স্থানীয় বইয়ের নাম আছে: Radhā Mohan Dev Varman Thākur, “Kak-barak-mā, a Grammar of the Traipur Language (in Bengali)”, কুমিল্লা, 1900। আমাদের আর্কাইভের ককবরক ভাষা-বিষয়ক লেখা এই বইকে লিখেছে ঠাকুর রাধামোহন দেববর্মনের ‘ককবরকমা’, 1900 সালের ককবরক ব্যাকরণ।
খণ্ড 1, ভাগ 1-এ (1927, পৃ. 63) গ্রিয়ারসন সারাংশে লিখেছেন, ত্রিপুরা বোড়ো দলের “remaining important language”, যার আবাস হিল টিপেরা ও পার্বত্য চট্টগ্রামের সংলগ্ন অংশ, আর ভাষাটির সঙ্গে ডিমাসা ও গারোর মিল আছে। খণ্ড 3, ভাগ 3-এর ম্রো অংশে (পৃ. 386) আলাদা করে সতর্ক করা হয়েছে: “Mrū is quite different from Mrung, the common name for Tipurā in the Chittagong Hill Tracts” — ম্রো আর ম্রুং এক ভাষা নয়।
মারমা ভাষা কেন গ্রিয়ারসনের জরিপের বাইরে
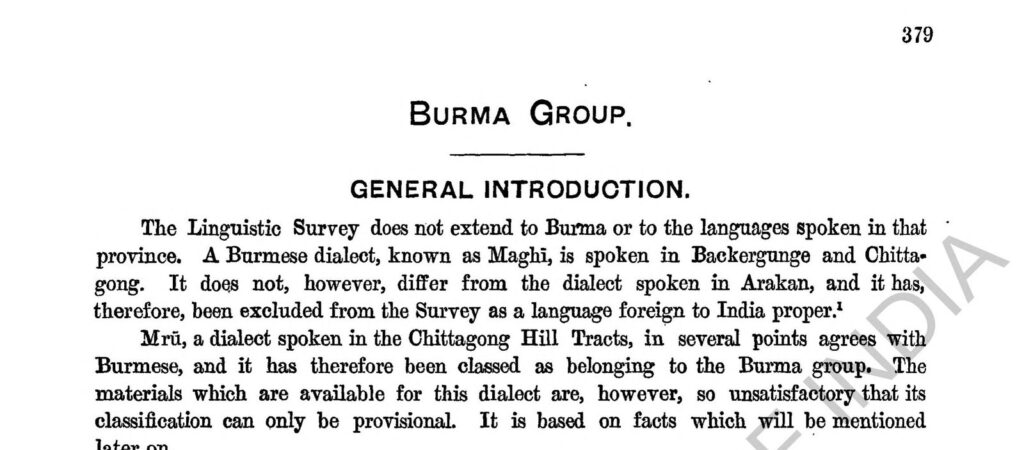
মারমা ভাষার কোনো অংশ জরিপে নেই। খণ্ড 3, ভাগ 3-এর বার্মা দলের ভূমিকায় (1904, পৃ. 379) লেখা: বাকেরগঞ্জ ও চট্টগ্রামে “Maghī” নামে একটি বর্মি উপভাষা বলা হয়, যা আরাকানের উপভাষা থেকে আলাদা নয়, তাই একে “a language foreign to India proper” — মূল ভারতের পক্ষে বিদেশি ভাষা — হিসেবে জরিপ থেকে বাদ রাখা হয়েছে।
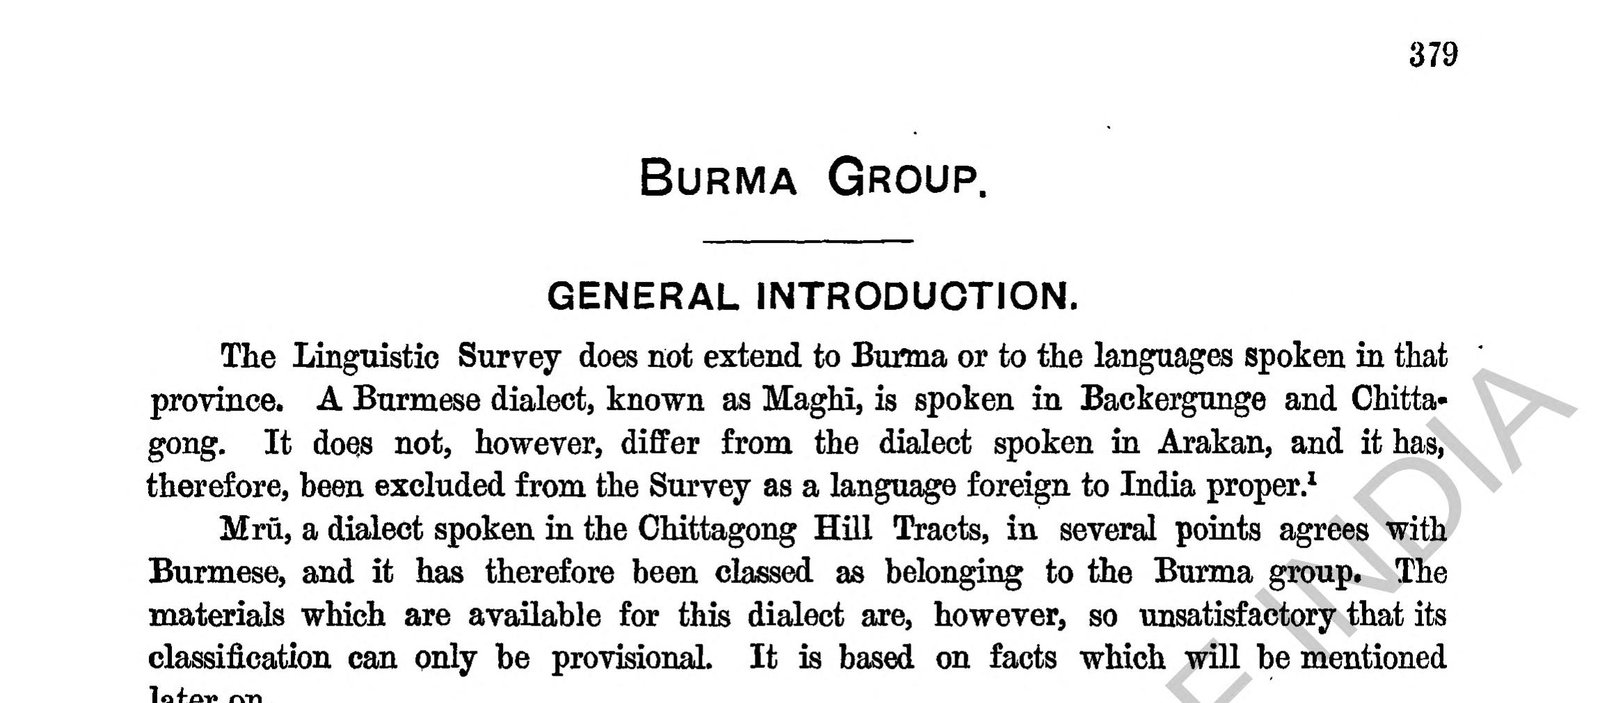
বাদ পড়লেও সংখ্যাটি একটি পাদটীকায় ছাপা আছে। “Maghī”-র বক্তা: বাকেরগঞ্জ 5,744; চট্টগ্রাম 16,417; পার্বত্য চট্টগ্রাম 22,500; মোট 44,661। আরেকটি পাদটীকা পাঠককে পাঠিয়েছে জার্মান প্রাচ্যবিদ্যা সমিতির পত্রিকা Zeitschrift der Deutschen Morgenländischen Gesellschaft-এর 1903 সালের 57তম খণ্ডে, যেখানে “Maghī”-র প্রধান বৈশিষ্ট্যগুলোর বিবরণ আছে বলে লেখা।
একই পাতায় নাম নিয়ে দুটি তথ্য: আরাকানিদের “natives of India” বলে “Maghs”, আর পেগুর বর্মিরা বলে “Rakhaing-tha” — রাখাইনের সন্তান। পাতার বাকি অংশে আরাকানি উপভাষার সাধারণ বৈশিষ্ট্য: পাহাড়ের ব্যবধানে বর্মি মূলধারা থেকে আলাদা হয়ে এর নিজস্ব বিকাশ হয়েছে, আর এর উচ্চারণ অনেক সময় বর্মির কথ্য রূপের চেয়ে লিখিত রূপের সঙ্গে বেশি মেলে।
খণ্ড 1, ভাগ 1-এ (1927, পৃ. 79) গ্রিয়ারসন আরেকটু বিশদে লিখেছেন: জরিপের এলাকায় বর্মির একমাত্র রূপ আরাকানি বা রাখাইন, যা বাকেরগঞ্জ, চট্টগ্রাম ও পার্বত্য চট্টগ্রামে পাওয়া যায়; এই এলাকাগুলোতে বক্তারা “really an overflow from Burma”, আর উপভাষাটির “true home” আকিয়াব, স্যান্ডোওয়ে ও বাসেইন। বক্তাদের এই বর্ণনা গ্রিয়ারসনের, ঔপনিবেশিক প্রশাসনের সীমানা-ভাবনা থেকে লেখা।
মারমা লিপি ও বর্ণমালার ইতিহাস জানতে দেখুন আমাদের ম্রাইমাজা: মারমা বর্ণমালা-বিষয়ক লেখা। জরিপের পাতায় মারমা বা মগ লিপির কোনো ছক নেই।
ম্রো ভাষা: “Mrū”, বার্মা দলে অস্থায়ীভাবে
ম্রো ভাষা আছে খণ্ড 3, ভাগ 3-এ (1904), বার্মা দলে, শিরোনাম “Mrū”, পৃ. 385 থেকে। পৃ. 379-এর ভূমিকায় লেখা, ভাষাটি কয়েকটি দিকে বর্মির সঙ্গে মেলে বলে বার্মা দলে রাখা হয়েছে, কিন্তু উপকরণ এত অসন্তোষজনক যে শ্রেণিবিন্যাসটি “can only be provisional” — কেবল অস্থায়ী।
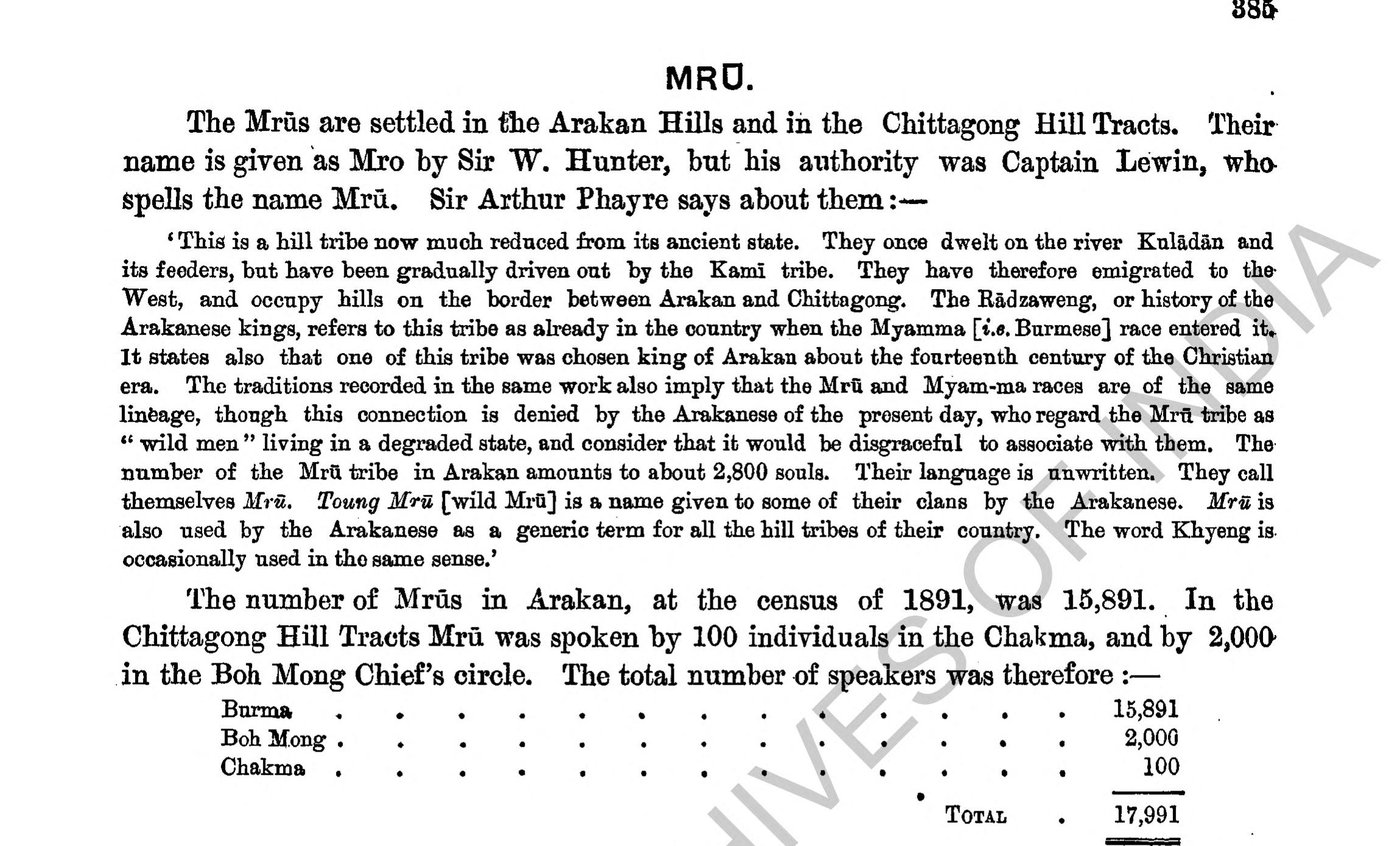
সংখ্যা: 1891 সালের শুমারিতে আরাকানে ম্রো 15,891; পার্বত্য চট্টগ্রামে বোমাং চিফের সার্কেলে 2,000 আর চাকমা সার্কেলে 100 জন ম্রো ভাষা বলেন — মোট 17,991। নাম নিয়ে জরিপ লিখেছে, Hunter নামটি “Mro” লিখেছিলেন, কিন্তু তাঁর সূত্র লুইন লিখেছিলেন “Mrū”।
পাতার শুরুতে Arthur Phayre-এর একটি দীর্ঘ উদ্ধৃতি আছে। তাঁর ভাষায়, আরাকানি রাজাদের ইতিহাস “Rādzaweng” ম্রোদের কথা বলে বর্মিরা আসার আগেই দেশে থাকা জাতি হিসেবে, আর জানায় চতুর্দশ শতকের দিকে এই জাতির একজন আরাকানের রাজা নির্বাচিত হয়েছিলেন। একই উদ্ধৃতিতে লেখা, তাঁদের ভাষা “unwritten” — লিখিত রূপ নেই। 1980-এর দশকে মেনলে ম্রো যে লিপি তৈরি করেন, তার ইতিহাস আছে আমাদের ম্রো লিপি-বিষয়ক লেখায়।
এরপর জরিপ Hunter-এর Statistical Account of Bengal থেকে লুইনের বিবরণের সংক্ষিপ্ত রূপ ছেপেছে — বসতি সাঙ্গু নদীর পশ্চিমে ও মাতামুহুরী নদীর ধারে, বিয়ে, উত্তরাধিকার, দেবতা ও শপথের কথা। এগুলো ভাষার তথ্য নয়, ঔপনিবেশিক নৃতাত্ত্বিক বর্ণনা; জরিপ নিজেও এগুলোকে Hunter থেকে নেওয়া বলে চিহ্নিত করেছে। ম্রো সমাজ নিয়ে আমাদের নিজস্ব লেখা ম্রো জাতি: ক্রামা, বর্ণমালা ও চিম্বুকের পাহাড়।
পৃ. 386-এর সূত্র-তালিকায় ম্রো ভাষার পুরনো শব্দতালিকাগুলোর ঠিকানা আছে — Phayre ও Hodgson (1853), লুইন (1869, পৃ. 147 থেকে শব্দতালিকা), Campbell (1874) প্রমুখ। Campbell-এর নমুনা সম্পর্কে জরিপের মন্তব্য: এত ছাপার ভুল যে “of very little use”।
বনযোগী ও পাংখু: আজকের বম ও পাংখোয়ার ভাষা জরিপে কীভাবে আছে
বম ভাষা জরিপে আছে “Banjōgī” নামে (পৃ. 144), পাংখোয়া “Pānkhū” নামে (পৃ. 152) — দুটিই খণ্ড 3, ভাগ 3-এ, কুকি-চিন দলের মধ্য চিন ভাগে। জরিপের ভাষায় দুটি ভাষা লুইনের সময়ে “almost identical” ছিল, লুসাইয়ের আত্মীয়, তবে চিন পাহাড়ের লাই ভাষার আরও কাছের।
আমাদের আর্কাইভের ‘বম ভাষা: বর্তমান ও ভবিষ্যৎ’ লেখাটি জানায়, পুরনো কোনো কোনো সূত্রে বনযোগী নামে জনগোষ্ঠীর কথা পাওয়া যায়, বম নামে নয়; বমরা নিজেদের বমজৌ বলতেন, আর বিভিন্ন লেখক তা বনযোগী, বনজো ইত্যাদি নানা রূপে লিখেছেন। নামের পুরো ইতিহাস আছে বম জাতি-বিষয়ক লেখায়।
বনযোগী (পৃ. 144–151)
জরিপ লেখে, বনযোগীরা চাকমা ও বোমাং চিফের সার্কেলে থাকেন; “Superintendent”-এর দেওয়া হিসাবে চাকমা সার্কেলে 300, বোমাং সার্কেলে 500, মোট 800 বক্তা। প্রথম উল্লেখ হিসেবে জরিপ Surgeon Macrae-এর 24 জানুয়ারি 1799 তারিখের একটি লেখার কথা বলেছে, যা 1801 সালে Asiatick Researches-এ ছাপা হয়।
পাতার বড় অংশ জুড়ে Hunter-এর মাধ্যমে লুইনের বিবরণ উদ্ধৃত — বনযোগী ও পাংখো দুই জাতি এক উৎস থেকে এসেছে বলে দাবি করে, দুই ভাইয়ের বংশধর হিসেবে; 1872 সালের শুমারিতে পার্বত্য চট্টগ্রামে 305 জন বনযোগী আর 177 জন পাংখো; বেশিরভাগ থাকেন সাঙ্গুর পূর্বে বোমাংয়ের এলাকায়। উদ্ধৃতিতে তাঁদের সৃষ্টিকথা ও দেবতার নামও আছে (Patyen, Khozing); সেগুলো লুইনের শোনা ও লেখা, জরিপের নিজের সংগ্রহ নয়।
পাংখু (পৃ. 152 থেকে)
পাংখু অংশের সংখ্যা: চাকমা সার্কেলে 200, বোমাং সার্কেলে 300, মোট 500। এর বাইরে অংশটি ছোট — পরিচিতির জন্য পাঠককে বনযোগী অংশে পাঠানো হয়েছে। উচ্চারণ নিয়ে লম্বা আলোচনার সারকথা: নমুনার বানান এতটাই অসংগত যে উচ্চারণ নিয়ে “any definite statement” করা অসম্ভব, আর ব্যাকরণের টীকা “with the utmost reserve” — সর্বোচ্চ সংশয় রেখে — দেওয়া হলো।
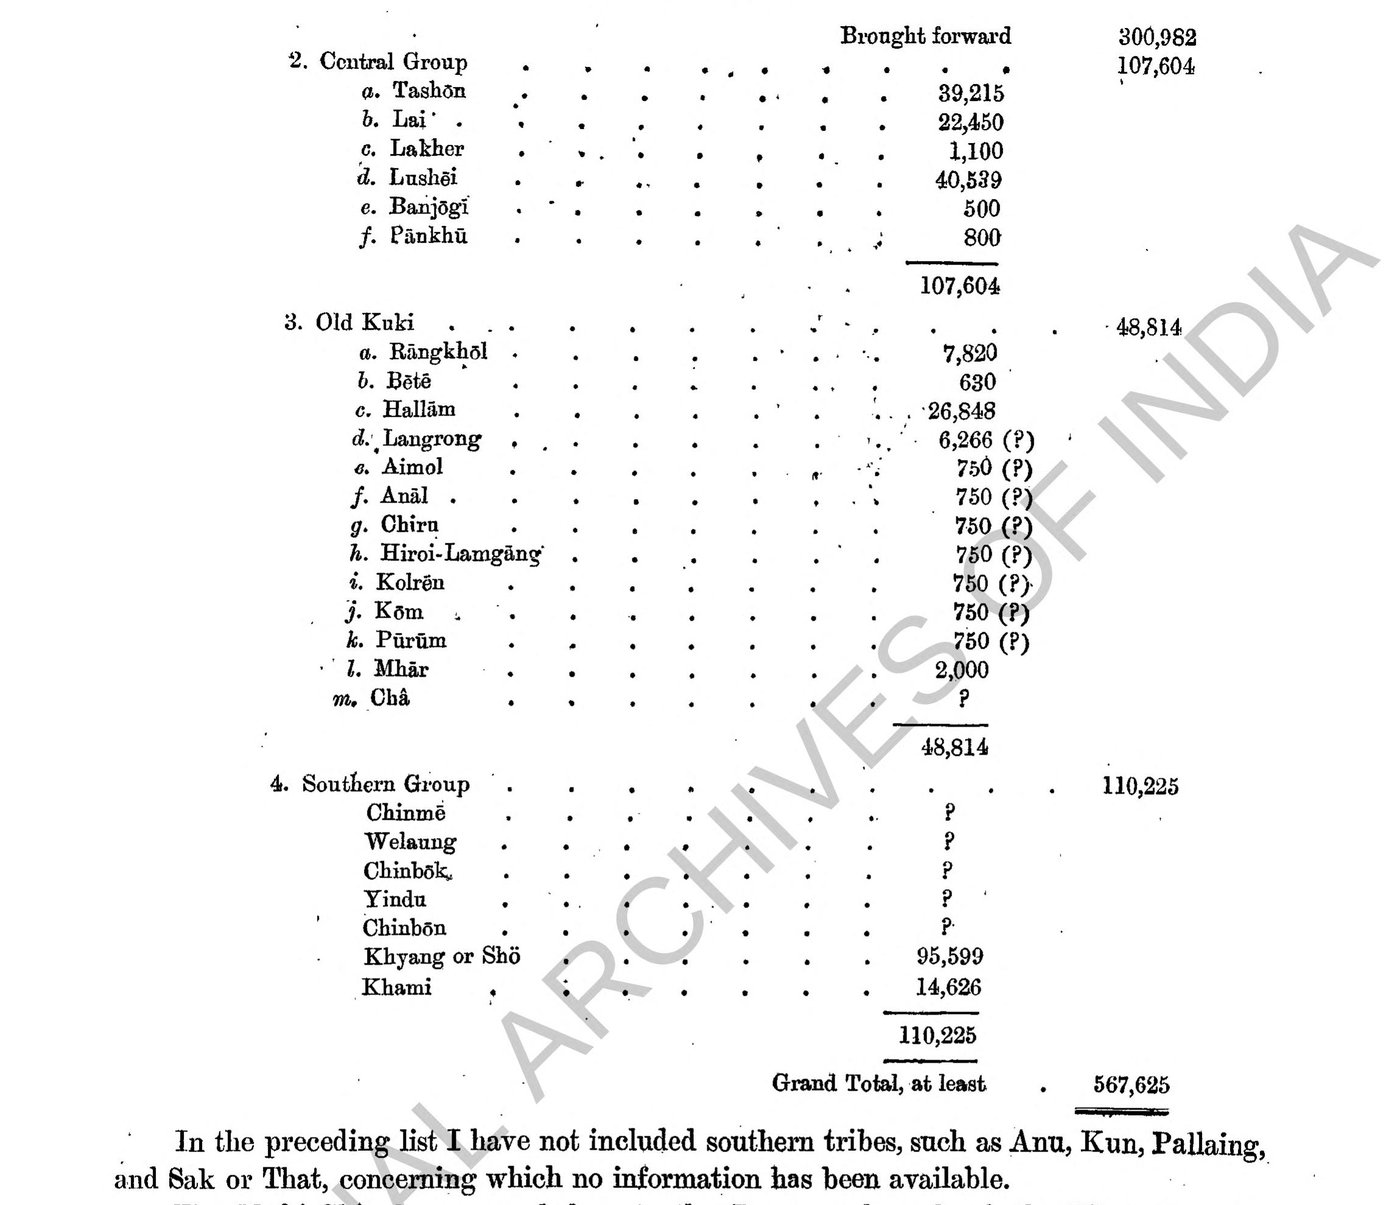
একই বইয়ে দুটি আলাদা সংখ্যা
খণ্ডের ভূমিকার সারণি (পৃ. 3) আর ভাষাভিত্তিক অংশ একই সংখ্যা দেয় না। সারণিতে Banjōgī 500, Pānkhū 800; ভাষাভিত্তিক অংশে বনযোগী 800 (পৃ. 144), পাংখু 500 (পৃ. 152)। পাঠক যে পাতা থেকেই উদ্ধৃত করুন, পাতার নম্বরসহ লেখা নিরাপদ।
1927 সালের খণ্ড 1, ভাগ 1-এ (পৃ. 75) গ্রিয়ারসন দুটি ভাষাকে বলেছেন “two unimportant languages spoken in the Chittagong Hill Tracts”, আর লিখেছেন এই দলের তিনটি ভাষার মধ্যে কেবল লুসাইয়ের “fairly accurate figures” পাওয়া যায়। “Unimportant” শব্দটি গ্রিয়ারসনের মূল্যায়ন, বক্তাসংখ্যার ভিত্তিতে।
খুমি ও খিয়াং: “Khami” আর “Sho or Khyang”
খুমি ভাষা জরিপে “Khami” নামে (পৃ. 347), খিয়াং “Sho or Khyang” নামে (পৃ. 331) — দুটিই খণ্ড 3, ভাগ 3-এর কুকি-চিন দলে, দক্ষিণ চিন ভাগে। খণ্ড 1-এ (1927) গ্রিয়ারসন লিখেছেন, দক্ষিণ চিন ভাষাগুলোর মধ্যে কেবল এই দুটি জরিপের আওতায় পড়ে।
খুমি (পৃ. 347 থেকে)
জরিপ লেখে, খুমিরা আরাকানের কালাদান নদী আর পার্বত্য চট্টগ্রামে বোমাং চিফের সার্কেলে সাঙ্গু নদীর উজানে থাকেন। 1891 সালের শুমারিতে বার্মায় খুমি 14,126; পার্বত্য চট্টগ্রাম থেকে “About 500” জনের হিসাব এসেছে। লুইনের উদ্ধৃতিতে বলা, সংখ্যাটি ওঠানামা করে, কারণ প্রতি বছর কিছু পরিবার কালাদানের আত্মীয়দের কাছে যায় বা ফেরে — সাঙ্গু থেকে পাহাড় পেরিয়ে দুই দিনের পথ।
নাম নিয়ে জরিপের পর্যবেক্ষণ: পার্বত্য চট্টগ্রাম থেকে আসা নমুনায় শব্দটি “khu-mi” ও “khai-mi” লেখা; জরিপের মতে শুদ্ধ রূপ “kha-mi”, যার অর্থ “মানুষ”। বর্মি ও আরাকানিদের দেওয়া একটি অবমাননাকর ডাকনামও পাতায় ব্যাখ্যাসহ উদ্ধৃত আছে, যা এখানে পুনরাবৃত্ত করা হলো না।
লিখিত রূপ নিয়ে জরিপের তথ্য: খুমির “no written literature”; আকিয়াবের খুমি উপভাষা আমেরিকান ব্যাপটিস্ট মিশনের Rev. L. Stilson 1850-এর দিকে লিখিত রূপ দেন, একটি পাঠ্য বই ও বানান-বই ছাপেন, কিন্তু মিশন সরে যাওয়ায় সেগুলো “remained unused”। পার্বত্য চট্টগ্রাম থেকে আসা দৃষ্টান্ত-অনুবাদ ও শব্দতালিকা “very corrupt”।
খিয়াং (পৃ. 331–346)
পৃ. 331-এর তথ্য: খিয়াং বা খ্যেংরা আরাকান ইয়োমার দুই পাশে থাকেন; লুইন তাঁদের পেয়েছিলেন পার্বত্য চট্টগ্রাম ও আরাকানের মাঝের পাহাড়শ্রেণির শাখাগুলোয়; “There are now about 100 Khyangs in the Boh Mong Chief’s circle” — বোমাং সার্কেলে এখন প্রায় 100 জন খিয়াং। নাম নিয়ে জরিপ লেখে, বর্মিরা তাঁদের “Chin” বলে, আর “Khyang” বা “Khyeng” সেই শব্দেরই আরাকানি উচ্চারণ; বিভিন্ন লেখক তাঁদের নিজ-নাম লিখেছেন “A-shö” (Houghton), “Hiou” বা “Shou” (Fryer), “Shyū” বা “Shoa” (Hodgson)।
পার্বত্য চট্টগ্রাম থেকে আসা দৃষ্টান্ত-অনুবাদ ও শব্দতালিকা দিয়ে উপভাষাটির ধারণা পাওয়া প্রায় অসম্ভব বলে জরিপ ব্যাকরণ-বিবরণে বার্মার Fryer ও Houghton-এর ব্যাকরণ ব্যবহার করেছে। পার্বত্য চট্টগ্রামের উপভাষার সবচেয়ে পুরনো তথ্য হিসেবে লুইনের শব্দতালিকার কথা বলা হয়েছে, আর সঙ্গে জানানো হয়েছে, সেটি দু-তিনটি বদল বাদে Phayre-এর আরাকানে তৈরি তালিকারই পুনর্মুদ্রণ।
খিয়াং ভাষার একটি সংখ্যা নিয়ে সতর্কতা দরকার। খণ্ডের ভূমিকার সারণিতে (পৃ. 3) “Khyang or Shō”-র পাশে 95,599। খিয়াং অংশের ভেতরে (পৃ. 331) লেখা, 1891 সালের শুমারিতে বার্মায় “Chins” 95,499। আমাদের খিয়াং জনগোষ্ঠী-বিষয়ক লেখায় সুগত চাকমার উদ্ধৃতিতে 95,599 সংখ্যাটি গ্রিয়ারসনের Linguistic Survey of India-র হিসাবে খিয়াংদের “সর্বমোট” জনসংখ্যা হিসেবে আছে, সাল 1921।
লুসাই, চাক, তঞ্চঙ্গ্যা: যাদের আলাদা পার্বত্য-অংশ জরিপে নেই
পার্বত্য চট্টগ্রামের তিনটি জনগোষ্ঠীর ভাষা জরিপে আলাদা করে পার্বত্য চট্টগ্রামের ভাষা হিসেবে আসেনি। লুসাইয়ের অংশ আছে, তবে তা লুসাই পাহাড়কেন্দ্রিক; চাকের সম্ভাব্য একটি উল্লেখ আছে কেবল তালিকার বাইরে রাখা নাম হিসেবে; আর তঞ্চঙ্গ্যা নামে কোনো অংশ পাওয়া যায়নি।
লুসাই
খণ্ড 3, ভাগ 3-এর “Lushei or Dulien” অংশ লুসাই পাহাড়ের ইতিহাস ও উপভাষা নিয়ে; ভূমিকার সারণিতে লুসাইয়ের মোট বক্তা 40,539। পার্বত্য চট্টগ্রামের লুসাইদের আলাদা কোনো সংখ্যা এই অংশে পাওয়া যায়নি। অংশটির অনেক তথ্য Major J. Shakespear-এর দেওয়া, তাঁর উদ্ধৃতিসহ।
চাক: “Sak or That”
খণ্ডের ভূমিকায় (পৃ. 3) কুকি-চিন বক্তার সারণির ঠিক নিচে লেখা: “In the preceding list I have not included southern tribes, such as Anu, Kun, Pallaing, and Sak or That, concerning which no information has been available.” — অনু, কুন, পাল্লাইং আর “Sak বা That”-এর কোনো তথ্য পাওয়া যায়নি বলে সারণিতে রাখা হয়নি।
আমাদের আর্কাইভে মংমং চাক ও চিংহ্লামংয়ের লেখা ‘চাক জাতির আদ্যোপান্ত’ জানায়, চাকরা নিজেদের “আচাক” বলেন, আরাকানিরা তাঁদের ডাকে “সাক (sak)”, কখনো “মিসাক”, আর তাঁদের “thek” বা “থেক” নামেও উল্লেখ করা হয়। জরিপের পাতায় “Sak or That” কোন জনগোষ্ঠী, তার কোনো ব্যাখ্যা নেই। চাক লেখাটির তথ্যসূত্রে গ্রিয়ারসনের জরিপের “Vol.1, Part : 1, P/77” উল্লেখ আছে।
তঞ্চঙ্গ্যা
খণ্ড 5 ভাগ 1, খণ্ড 3 ভাগ 2 ও খণ্ড 3 ভাগ 3-এর পাঠে “Tanchangya”, “Tongchangya” বা কাছাকাছি কোনো নামে আলাদা অংশ বা উল্লেখ পাওয়া যায়নি। 2022 সালের জনশুমারিতে তঞ্চঙ্গ্যা জনসংখ্যা 45,974 (আমাদের জনশুমারি 2022-বিষয়ক লেখা অনুযায়ী)। Glottolog আজ তঞ্চঙ্গ্যাকে চাকমার সঙ্গে একই “Southeastern Bengali” দলে রাখে; জরিপের সময় তঞ্চঙ্গ্যা ভাষা কোন নামে, কোন সংখ্যায় গোনা হয়েছিল, তা জরিপের পাতা থেকে জানা যায়নি।
গ্রিয়ারসনের শ্রেণিবিন্যাস আর আজকের শ্রেণিবিন্যাস পাশাপাশি
পার্বত্য চট্টগ্রামের ভাষাগুলোর পরিবার নিয়ে গ্রিয়ারসনের জরিপ আর আজকের Glottolog মূল ভাগে মোটামুটি এক জায়গায় — চাকমা ইন্দো-আর্য, বাকিগুলো তিব্বতি-বর্মি বা চীনা-তিব্বতি। পার্থক্য দেখা যায় ম্রোর ক্ষেত্রে, আর ভেতরের দলের নামে। নিচের ছকে দুটি পাশাপাশি; Glottolog-এর শ্রেণি তাদের ওয়েবসাইটের ভাষা-পাতা থেকে নেওয়া।
| ভাষা | গ্রিয়ারসনের জরিপে (1903–04) | Glottolog-এ (আজ) |
|---|---|---|
| চাকমা | ইন্দো-আর্য › বাংলা › দক্ষিণ-পূর্ব উপভাষা › “Chākmā Sub-dialect” | Indo-Aryan › … › Gauda-Banga › Southeastern Bengali › Chakma |
| ত্রিপুরা | তিব্বতি-বর্মি › বোড়ো দল › Tipurā | Sino-Tibetan › Brahmaputran › Bodo-Garo › Boroic › Dimasa-Kokborok › Tipperic › Kok Borok |
| মারমা | “Maghī” — বর্মির উপভাষা, জরিপের বাইরে | Sino-Tibetan › … › Burmish › Southern Burmish › Mranmaic › Arakanese-Marma › Marma |
| ম্রো | তিব্বতি-বর্মি › বার্মা দল (অস্থায়ী) › Mrū | Sino-Tibetan › Mruic › Mru |
| বম | কুকি-চিন › মধ্য চিন › Banjōgī | Kuki-Chin › Central Kuki-Chin › Core Central › Lai Chin › Falamic › Bawm Chin |
| পাংখোয়া | কুকি-চিন › মধ্য চিন › Pānkhū | Kuki-Chin › Central Kuki-Chin › Core Central Kuki-Chin › Pangkhua |
| খুমি | কুকি-চিন › দক্ষিণ চিন › Khami | Kuki-Chin › Peripheral Kuki-Chin › Khomic › Khumi Chin |
| খিয়াং | কুকি-চিন › দক্ষিণ চিন › Sho or Khyang | Kuki-Chin › Peripheral › South Peripheral › Ashoic › Asho Chin › Khyang |
| তঞ্চঙ্গ্যা | আলাদা অংশ পাওয়া যায়নি | Indo-Aryan › … › Southeastern Bengali › Tangchangya |
ম্রোর ক্ষেত্রে জরিপ নিজেই বলেছিল শ্রেণিটি “provisional”; Glottolog আজ ম্রোকে কোনো বড় দলের ভেতরে না রেখে চীনা-তিব্বতি পরিবারের নিচে সরাসরি “Mruic” নামে আলাদা শাখা হিসেবে রাখে। কুকি-চিন ভাষাগুলোর আজকের শ্রেণিবিন্যাস নিয়ে আরও বিস্তারিত আছে আমাদের কুকি-চিন ভাষার লেখায়।
1903–04 সালের সংখ্যা আর 2022 সালের জনশুমারি পাশাপাশি
জরিপের সংখ্যা আর আজকের জনশুমারির সংখ্যা সরাসরি তুলনীয় নয়: জরিপ গুনেছে পার্বত্য চট্টগ্রামে ভাষার বক্তা, অনেক ক্ষেত্রে আন্দাজে; 2022 সালের জনশুমারি গুনেছে সারা দেশে জাতিগোষ্ঠীর মানুষ। তবু দুটি পাশাপাশি রাখলে পাঠক বুঝতে পারেন পুরনো খণ্ডের সংখ্যাগুলো কোন মাপের।
| জনগোষ্ঠী / ভাষা | জরিপ: পার্বত্য চট্টগ্রামে বক্তা | জনশুমারি 2022: বাংলাদেশে জনসংখ্যা |
|---|---|---|
| চাকমা | 20,006 | 483,365 |
| মারমা | 22,500 (“Maghī”, পাদটীকা) | 224,299 |
| ত্রিপুরা | 15,250 | 156,620 |
| ম্রো | 2,100 | 52,463 |
| বম | 800 (পৃ. 144) / 500 (পৃ. 3) | 13,193 |
| খিয়াং | প্রায় 100 | 4,826 |
| খুমি | প্রায় 500 | 3,780 |
| পাংখোয়া | 500 (পৃ. 152) / 800 (পৃ. 3) | 1,857 |
2022 সালের সংখ্যাগুলো বাংলাদেশ পরিসংখ্যান ব্যুরোর জনশুমারির, আমাদের জনশুমারি 2022: 50 জাতিগোষ্ঠীর জনসংখ্যা লেখা থেকে নেওয়া। জরিপের সংখ্যাগুলোর উৎস জরিপ নিজেই কখনো “the Superintendent”, কখনো শুমারি, কখনো লুইনের হিসাব বলে উল্লেখ করেছে।
জরিপের পরিভাষা কীভাবে পড়বেন: “tribe”, “corrupt”, “wild”
জরিপের ভাষা ঔপনিবেশিক প্রশাসনের ভাষা। “Wilder tribes”, “broken dialect”, “curious dialect”, “unimportant languages”, ম্রো অংশে উদ্ধৃত “wild men” — এগুলো গ্রিয়ারসন, Konow বা তাঁদের উদ্ধৃত কর্মকর্তাদের শব্দ। আজকের পাঠে এগুলো উদ্ধৃতি হিসেবেই পড়া উচিত, তথ্য হিসেবে নয়।
একটি শব্দ আলাদা করে বোঝা দরকার। জরিপ যখন কোনো নমুনাকে “corrupt” বলে, সেখানে অর্থ ভাষা নয়, লেখা: কর্মকর্তা বা অনুবাদকের পাঠানো বানান অসংগত, শব্দে শব্দে অনুবাদ ভুল, তাই ভাষাটির উচ্চারণ বা ব্যাকরণ নির্ভরযোগ্যভাবে বোঝা যায় না। পাংখু অংশে জরিপ নিজেই লিখেছে, এই অসংগতি “can only be due to want of precision in the perception of the sounds” — শব্দ শোনার নির্ভুলতার অভাব থেকেই।
নাম নিয়েও জরিপ সতর্ক করেছে। খণ্ড 1-এ (পৃ. 19) গ্রিয়ারসন লেখেন, অনেক ভাষার নাম বক্তাদের দেওয়া নয়, প্রতিবেশীদের দেওয়া, আর সেগুলো “not always complimentary” — সবসময় সম্মানজনক নয়। পার্বত্য চট্টগ্রামের অংশগুলোতে এর উদাহরণ আছে: “Maghs”, খুমিদের বর্মি ডাকনাম, আরাকানিদের “Toung Mrū” (বুনো ম্রো)। আর জরিপের অনেক নাম — Banjōgī, Khami, Sho or Khyang — আজ বম, খুমি, খিয়াং নামে চলে; পুরনো নামে খুঁজলে পাতা পাওয়া যায়, আজকের নামে খুঁজলে প্রায়ই যায় না।
জরিপের নৃতাত্ত্বিক উদ্ধৃতিগুলো — বিয়ে, ধর্ম, শপথ, পোশাক — বেশিরভাগ লুইন ও Hunter-এর পুরনো বই থেকে নেওয়া, জরিপের নিজের সংগ্রহ নয়। সেগুলোর বিষয়ে আজকের সমাজের নিজের লেখা বেশি নির্ভরযোগ্য সূত্র; আমাদের পার্বত্য চট্টগ্রাম পাতায় প্রতিটি জনগোষ্ঠীর লেখা একসঙ্গে আছে।
স্ক্যান কোথায় পড়বেন: archive.org ও DSAL-এ কোন খণ্ড কোন লিংকে
জরিপের সব খণ্ড পাবলিক ডোমেইনে, বিনামূল্যে পড়া ও নামানো যায়। দুটি জায়গা সবচেয়ে সুবিধার: Internet Archive (archive.org), যেখানে একই খণ্ডের একাধিক স্ক্যান আছে, আর DSAL, যেখানে সব খণ্ড এক তালিকায়।
| খণ্ড | কী আছে | archive.org-এ সরাসরি পাতা |
|---|---|---|
| খণ্ড 5, ভাগ 1 (1903) | চাকমা (পৃ. 321–350), দক্ষিণ-পূর্ব বাংলা (পৃ. 291) | পৃ. 321 খুলুন (এই স্ক্যানে ছাপা পাতা আর স্ক্যান-ক্রমিক 5–6 ঘর সরে আছে) |
| খণ্ড 3, ভাগ 2 (1903) | ত্রিপুরা (পৃ. 109) | পৃ. 109 খুলুন |
| খণ্ড 3, ভাগ 3 (1904) | সারণি (পৃ. 3), বনযোগী (144), পাংখু (152), খিয়াং (331), খুমি (347), বার্মা দল ও মারমা (379), ম্রো (385) | পৃ. 379 খুলুন (এই কপিতে ছাপা পাতার নম্বর ধরেই খোলা যায়) |
| খণ্ড 1, ভাগ 1 (1927) | পদ্ধতি (পৃ. 18–21), সারাংশ: ত্রিপুরা (63), বনযোগী-পাংখু (75), আরাকানি (79), চাকমা (153–154) | খণ্ডটি খুলুন |
| খণ্ড 1, ভাগ 2 (1928) | তুলনামূলক শব্দতালিকা — ত্রিপুরা, বনযোগী, ম্রো, চাকমাসহ | খণ্ডটি খুলুন |
খণ্ড 1, ভাগ 2-এর তুলনামূলক শব্দতালিকায় প্রতিটি ভাষার একটি ক্রমিক নম্বর আছে; সেখানে ত্রিপুরা 151, বনযোগী 227, ম্রো 264 আর চাকমা 551 নম্বরে। একটি শব্দের রূপ সব ভাষায় একসঙ্গে দেখতে এই নম্বরগুলো দিয়ে খোঁজা সহজ।
DSAL-এ পড়ার নিয়ম
DSAL-এর Linguistic Survey of India পাতায় প্রতিটি খণ্ডের নামের ওপর ক্লিক করলে BookReader-এ বইটি খোলে। পার্বত্য চট্টগ্রামের জন্য দরকারি তিনটি: “Vol. 3, Pt. 2” (বোড়ো, নাগা, কাচিন), “Vol. 3, Pt. 3” (কুকি-চিন ও বার্মা) আর “Vol. 5, Pt. 1” (বাংলা ও অসমিয়া)। BookReader-এর পাতা-নম্বর স্ক্যানের ক্রমিক, ছাপা পাতার নম্বর নয়; তাই ছাপা নম্বর মেলাতে কয়েক পাতা আগে-পিছে যেতে হতে পারে।
archive.org-এ বেশ কয়েকটি কপি “Digital Library of India” থেকে এসেছে (নাম শুরু “in.ernet.dli”)। কোনো কোনো কপির শিরোনাম ভুল লেখা; যেমন “Linguistic Survey Of India Vol Iii Part Ii” নামের একটি কপি খুললে ভেতরে অন্য একটি বই পাওয়া যায়। ওপরের ছকের লিংকগুলো খুলে ভেতরের পাতা মিলিয়ে দেখা হয়েছে।
শব্দ খোঁজার জন্য archive.org-এর প্রতিটি খণ্ডে “Full Text” আছে, তবে তা যন্ত্রে পড়া (OCR), চাকমা হরফ আর ছকের সংখ্যায় প্রচুর ভুল থাকে। সংখ্যা উদ্ধৃত করার আগে ছবির পাতাটি দেখে নেওয়া ভালো — এই লেখার সব সংখ্যা সেভাবেই মেলানো।
গ্রামোফোন রেকর্ডিং
DSAL-এর পরিচিতি-পাতা জানায়, জরিপের পরিপূরক হিসেবে 1913 থেকে 1929 সালের মধ্যে দক্ষিণ এশিয়ায় গ্রামোফোন রেকর্ডিং সংগ্রহ করা হয়েছিল, আর গল্প, গান ও কবিতার সেই রেকর্ডিংয়ের ডিজিটাল কপি DSAL থেকে পাওয়া যায়। পার্বত্য চট্টগ্রামের কোনো ভাষার রেকর্ডিং সেই সংগ্রহে আছে কি না, তা জানা যায়নি।
সচরাচর জিজ্ঞাসা
গ্রিয়ারসনের ভাষা জরিপে চাকমা ভাষা কোন খণ্ডে আছে?
Linguistic Survey of India-র খণ্ড 5, ভাগ 1-এ (কলকাতা, 1903), বাংলা ভাষার দক্ষিণ-পূর্ব উপভাষার ভেতরে, “Chākmā Sub-dialect” শিরোনামে, পৃ. 321 থেকে 350 পর্যন্ত। সেখানে বর্ণমালার ছক, ব্যাকরণের সংক্ষিপ্ত টীকা, চাকমা হরফে অপব্যয়ী পুত্রের দৃষ্টান্ত আর একটি লোককথা আছে। পৃ. 351 থেকে শুরু তুলনামূলক শব্দ ও বাক্যের তালিকা।
গ্রিয়ারসন কি চাকমাকে বাংলার উপভাষা বলেছিলেন?
হ্যাঁ। জরিপ চাকমাকে দক্ষিণ-পূর্ব বাংলার “sub-dialect” হিসেবে রেখেছে, তবে একই পাতায় (খণ্ড 5, ভাগ 1, পৃ. 321) লিখেছে, ভাষাটি এত বদলেছে যে আলাদা ভাষা হিসেবে গণ্য হওয়ার মর্যাদা “almost” পায়। আমাদের আর্কাইভের 2017 সালের একটি প্রবন্ধ এই শ্রেণিবিন্যাসের সমালোচনা করেছে।
Linguistic Survey of India-তে চাকমা বর্ণমালা কে পাঠিয়েছিলেন?
জরিপ অনুযায়ী তথ্য দিয়েছিলেন দেওয়ান কৃষ্টচন্দ্র, যাঁকে গ্রিয়ারসন লিখেছেন “a gentleman of Chākmā nationality”; তা গ্রিয়ারসনের কাছে পাঠিয়েছিলেন পার্বত্য চট্টগ্রামের সহকারী কমিশনার J. A. Cave-Browne। ছকটি ছাপা হয় 1903 সালে, খণ্ড 5, ভাগ 1-এর পৃ. 321–323-এ।
মারমা ভাষা গ্রিয়ারসনের জরিপে নেই কেন?
খণ্ড 3, ভাগ 3-এর পৃ. 379-এ লেখা, চট্টগ্রাম অঞ্চলের “Maghī” আরাকানের উপভাষা থেকে আলাদা নয়, তাই একে “a language foreign to India proper” হিসেবে বাদ রাখা হয়েছে। 1927 সালের খণ্ড 1-এ (পৃ. 79) গ্রিয়ারসন এই এলাকার বক্তাদের লিখেছেন “really an overflow from Burma”। পাদটীকায় বক্তার সংখ্যা আছে: পার্বত্য চট্টগ্রামে 22,500, মোট 44,661।
জরিপে ত্রিপুরা ভাষাকে কী নামে লেখা হয়েছে?
“Tipurā” নামে, বোড়ো দলের ভাষা হিসেবে, খণ্ড 3, ভাগ 2-এর (1903) পৃ. 109 থেকে। পার্বত্য চট্টগ্রামে বক্তা ধরা হয়েছে 15,250, আর লেখা আছে এখানে ভাষাটিকে “Mrung”-ও বলা হয়। সূত্র-তালিকায় ঠাকুর রাধামোহন দেববর্মনের 1900 সালের ককবরক ব্যাকরণের নাম আছে।
ম্রো আর ম্রুং কি একই ভাষা?
না। জরিপের খণ্ড 3, ভাগ 3-এর পৃ. 386-এ স্পষ্ট লেখা: “Mrū is quite different from Mrung, the common name for Tipurā in the Chittagong Hill Tracts।” ম্রো (Mrū) রাখা হয়েছে বার্মা দলে, আর ম্রুং পার্বত্য চট্টগ্রামে ত্রিপুরা ভাষার প্রচলিত নাম, যা বোড়ো দলে।
জরিপে ম্রো ভাষার বক্তা কতজন ধরা হয়েছিল?
খণ্ড 3, ভাগ 3-এর পৃ. 385 অনুযায়ী মোট 17,991: আরাকানে 1891 সালের শুমারিতে 15,891, পার্বত্য চট্টগ্রামের বোমাং সার্কেলে 2,000 আর চাকমা সার্কেলে 100। জরিপ এর শ্রেণিবিন্যাসকে “provisional” বলেছে, আর পার্বত্য চট্টগ্রাম থেকে আসা নমুনাকে “extremely corrupt and untrustworthy”।
বম ভাষা জরিপে কী নামে আছে?
“Banjōgī” নামে, খণ্ড 3, ভাগ 3-এর পৃ. 144 থেকে, কুকি-চিন দলের মধ্য চিন ভাগে। ভাষাভিত্তিক অংশে পার্বত্য চট্টগ্রামে বক্তা 800 (চাকমা সার্কেল 300, বোমাং 500), কিন্তু খণ্ডের ভূমিকার সারণিতে (পৃ. 3) 500। আমাদের আর্কাইভ জানায়, বনযোগী বমদের পুরনো বহিরাগত নাম।
খুমি আর খিয়াং ভাষা জরিপের কোন পাতায়?
দুটিই খণ্ড 3, ভাগ 3-এ (1904), কুকি-চিন দলের দক্ষিণ চিন ভাগে। খুমি “Khami” নামে পৃ. 347 থেকে, পার্বত্য চট্টগ্রাম থেকে “About 500” বক্তা; খিয়াং “Sho or Khyang” নামে পৃ. 331 থেকে, বোমাং সার্কেলে প্রায় 100 জন। দুটি ভাষার নমুনাই পার্বত্য চট্টগ্রাম থেকে পাঠানো হয়েছিল।
তঞ্চঙ্গ্যা ভাষা কি গ্রিয়ারসনের জরিপে আছে?
খণ্ড 5 ভাগ 1, খণ্ড 3 ভাগ 2 ও খণ্ড 3 ভাগ 3-এর পাঠে তঞ্চঙ্গ্যা নামে কোনো আলাদা অংশ পাওয়া যায়নি। আজকের Glottolog তঞ্চঙ্গ্যাকে চাকমার সঙ্গে একই “Southeastern Bengali” দলে রাখে, কিন্তু জরিপের সময় এই ভাষা অন্য কোনো নামে গোনা হয়েছিল কি না, জরিপের পাতা থেকে জানা যায় না।
Linguistic Survey of India বিনামূল্যে কোথায় পড়া যায়?
Internet Archive (archive.org) আর শিকাগো বিশ্ববিদ্যালয়ের Digital South Asia Library (dsal.uchicago.edu/books/lsi)-তে। পার্বত্য চট্টগ্রামের জন্য দরকার খণ্ড 3 ভাগ 2, খণ্ড 3 ভাগ 3 আর খণ্ড 5 ভাগ 1। বইগুলো 1903–1928 সালে প্রকাশিত, পাবলিক ডোমেইনে; পুরো PDF নামানো যায়।
জরিপের নমুনা কীভাবে সংগ্রহ করা হয়েছিল?
জেলা কর্মকর্তাদের প্রতিটি স্থানীয় ভাষার তিনটি নমুনা পাঠাতে বলা হয়েছিল: অপব্যয়ী পুত্রের দৃষ্টান্তের অনুবাদ, একটি স্থানীয় পাঠ, আর শব্দ ও বাক্যের মানক তালিকা। খণ্ড 1-এ গ্রিয়ারসন লেখেন, নমুনা আসা শুরু হয় 1897 সালে, বেশিরভাগ পৌঁছায় 1900-এর শেষে; সম্পাদনা শুরু 1898 সালে।
যা এখনো জানা যায়নি
- পার্বত্য চট্টগ্রামের নমুনার অনুবাদক কারা। চাকমা বর্ণমালার তথ্যদাতা ছাড়া আর কোনো স্থানীয় অনুবাদক বা তথ্যদাতার নাম জরিপের পাতায় নেই। ত্রিপুরা, ম্রো, বনযোগী, পাংখু, খুমি ও খিয়াং নমুনাগুলো কে লিখেছিলেন, তা জানা যায়নি।
- মূল পাণ্ডুলিপি কোথায়। জেলা থেকে পাঠানো হাতে লেখা নমুনাগুলো — বিশেষ করে বাংলা হরফে লেখা ত্রিপুরা নমুনা আর চাকমা হরফের মূল — আজ কোন সংগ্রহে আছে, কোনো উৎসে পাওয়া যায়নি।
- “Sak or That” কারা। জরিপ এই নাম তালিকার বাইরে রেখেছে তথ্যের অভাবে। নামটি চাক জনগোষ্ঠীকেই বোঝায় কি না, জরিপের পাতায় বলা নেই।
- তঞ্চঙ্গ্যা ভাষা কোথায় গোনা হয়েছিল। জরিপে তঞ্চঙ্গ্যা নামে কিছু পাওয়া যায়নি; ভাষাটি চাকমার 20,006 জনের ভেতরে ধরা হয়েছিল, না বাদ পড়েছিল, তা জানা যায়নি।
- বনযোগী ও পাংখুর সংখ্যা। একই খণ্ডে দুটি সংখ্যা উল্টো ছাপা (500 ও 800)। কোনটি ছাপার ভুল, জরিপের পরবর্তী সংশোধনী-খণ্ডে (Addenda et Corrigenda) তা ঠিক করা হয়েছিল কি না, যাচাই করা যায়নি।
- খিয়াং সংখ্যার সাল। 95,599 সংখ্যাটি 1904 সালের খণ্ডের সারণিতে আছে; আমাদের খিয়াং লেখায় সুগত চাকমার উদ্ধৃতিতে সালটি 1921। 1921 সালের অন্য কোনো সূত্রে একই সংখ্যা আছে কি না, জানা যায়নি।
- “Jāmāimārōni”-র চাকমা নাম। চাকমা লোককথার এই জায়গাটি চাকমা ভাষায় কী নামে পরিচিত, আর কাহিনিটির অন্য কোনো লিখিত রূপ আছে কি না, পাওয়া যায়নি।
- রেকর্ডিং। 1913–1929 সালের গ্রামোফোন সংগ্রহে পার্বত্য চট্টগ্রামের কোনো ভাষা আছে কি না, জানা যায়নি।
তথ্যসূত্র
মূল নথি (Linguistic Survey of India, কলকাতা, Office of the Superintendent of Government Printing)
- G. A. Grierson (সম্পা.), Linguistic Survey of India, Vol. V, Part I: Indo-Aryan Family, Eastern Group — Bengali and Assamese, 1903 — পৃ. 291 (South-Eastern Bengali), 321–350 (Chākmā Sub-dialect), 351 (Standard List)। Internet Archive
- G. A. Grierson (সম্পা.), Linguistic Survey of India, Vol. III, Part II: Specimens of the Bodo, Nāgā and Kachin Groups, 1903 — পৃ. 109 (Tipurā)। Internet Archive
- G. A. Grierson (সম্পা.), Linguistic Survey of India, Vol. III, Part III: Specimens of the Kuki-Chin and Burma Groups, 1904 — পৃ. 1–3 (ভূমিকা ও সারণি), 144 (Banjōgī), 152 (Pānkhū), 331 (Sho or Khyang), 347 (Khami), 379 (Burma Group), 385–386 (Mrū)। Internet Archive
- G. A. Grierson, Linguistic Survey of India, Vol. I, Part I: Introductory, 1927 — পৃ. 18–21 (পদ্ধতি), 63, 75, 79, 153–154, 199 (Konow-এর প্রতি কৃতজ্ঞতা)। Internet Archive
- G. A. Grierson, Linguistic Survey of India, Vol. I, Part II: Comparative Vocabulary, 1928। Internet Archive
- Digital South Asia Library, University of Chicago — “Linguistic Survey of India” খণ্ড-তালিকা ও “About the Linguistic Survey of India”। খণ্ড-তালিকা · পরিচিতি
জুমজার্নালের আর্কাইভ
- মেয়েরেগা, “বিশ্বের বিভিন্ন ভাষা আন্দোলন ও চাকমা ভাষার দশা”, 18 ফেব্রুয়ারি 2017 — গ্রিয়ারসনের শ্রেণিবিন্যাসের সমালোচনা; সৌরভ সিকদারের মন্তব্য (রাজীব নূরের লেখার সূত্রে)। লিংক
- তনয় দেওয়ান, “চাংমাটারা – চাকমা জাতির সংক্ষিপ্ত ইতিহাস” — কৃষ্টচন্দ্র দেওয়ান ও 1903 সালের বর্ণমালা। লিংক
- মংমং চাক ও চিংহ্লামং, “চাক জাতির আদ্যোপান্ত” — “সাক”, “থেক” নাম। লিংক
- “বম ভাষা: বর্তমান ও ভবিষ্যৎ” — বনযোগী ও বমজৌ নাম। লিংক
- “ককবরক ভাষা” — ঠাকুর রাধামোহন দেববর্মনের ‘ককবরকমা’ (1900)। লিংক
অন্যান্য
- বাংলাপিডিয়া, “গ্রিয়ারসন, জর্জ আব্রাহাম”। লিংক; ইংরেজি ভুক্তি “Grierson, George Abraham” (Hakim Arif)। লিংক
- Wikipedia, “Linguistic Survey of India”। লিংক
- Glottolog 5 (Max Planck Institute for Evolutionary Anthropology) — Chakma (chak1266), Tangchangya (tang1330), Kok Borok (kokb1239), Marma (marm1234), Mru (mruu1242), Bawm Chin (bawm1236), Pangkhua (pank1249), Khumi Chin (khum1248), Khyang (khya1239)। chak1266 · tang1330 · kokb1239 · marm1234 · mruu1242 · bawm1236 · pank1249 · khum1248 · khya1239
- বাংলাদেশ পরিসংখ্যান ব্যুরো, জনশুমারি ও গৃহগণনা 2022 — জাতিগোষ্ঠীভিত্তিক জনসংখ্যা, জুমজার্নালের সংকলনে। লিংক
- জুমজার্নাল — চাকমা লিপি, সতীশচন্দ্র ঘোষের ‘চাকমা জাতি’, কুকি-চিন ভাষা, আদিবাসী ভাষার অভিধান, পাংখোয়া, খিয়াং, বম, ম্রো ও মারমা লিপি নিয়ে লেখা (লিংক লেখার মধ্যে)।
সর্বশেষ হালনাগাদ: 3 নভেম্বর 2026
প্রসঙ্গ:আদিবাসী ভাষা
জুমজার্নালে প্রকাশিত লেখাসমূহে তথ্যমূলক ভুল-ভ্রান্তি থেকে যেতে পারে অথবা যেকোন লেখার সাথে আপনার ভিন্নমত থাকতে পারে। আপনার মতামত এবং সঠিক তথ্য দিয়ে আপনিও লিখুন অথবা লেখা পাঠান। লেখা পাঠাতে কিংবা যেকোন ধরনের প্রয়োজনে যোগাযোগ করুন - jumjournal@gmail.com এই ঠিকানায়।